

مدل GPT 5.6: مقایسه سول، ترا و لونا و چالشهای رقابتی

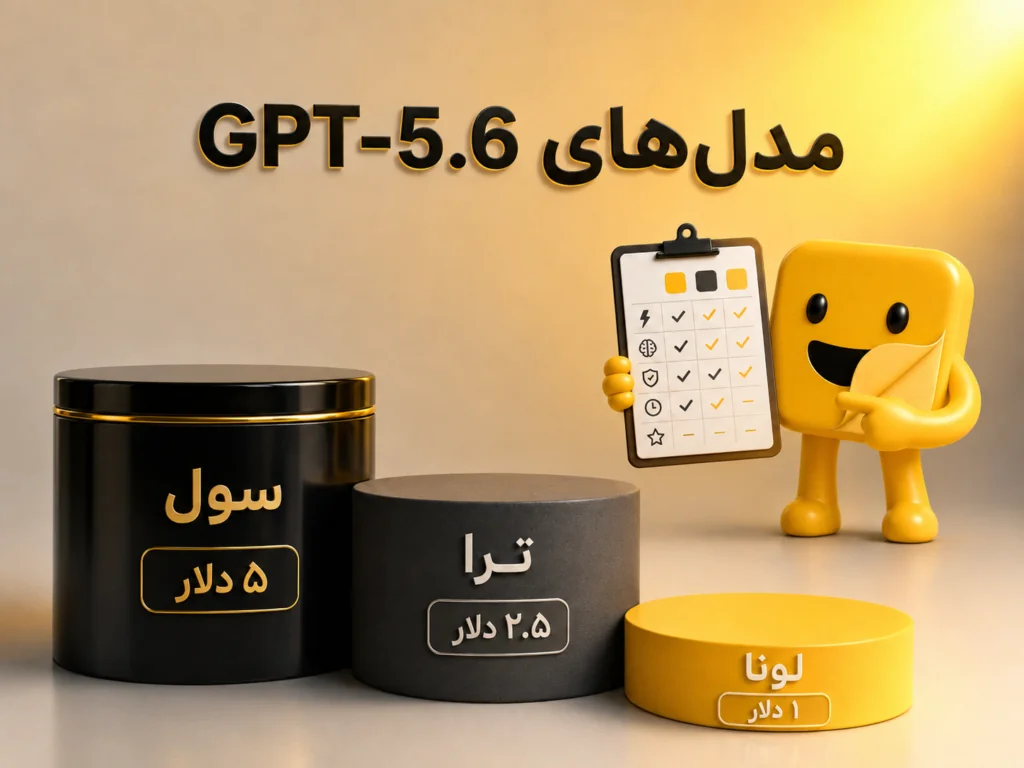
وقتی اوپنایآی اعلام کرد که GPT 5.6 رو به سه مدل جداگانه تقسیم میکنه، خیلیها فکر کردن دوباره داریم وارد همون سردرگمیِ قدیمی میشیم. یادته چند وقت پیش چندتا مدل GPT 4 داشتیم که هیچکس نمیفهمید کدوم واسه چه کاری درسته؟ حالا با مدل GPT 5.6 قرار بود داستان فرق کنه سه مدل سول، ترا و لونا که هرکدوم واسه یه کاربرد خاص طراحی شدن.
اما چیزی که کمتر ازش حرف میزنن، این چالشهای واقعیه که این مدلها با اون دستوپنجه نرم میکنن: فشارِ قیمتیِ مدلهای چینی از یک طرف، و محدودیتهای دولتیِ آمریکا از طرف دیگه. تو این مقاله میخوام رک و بدون حاشیه بررسی کنم که این سه مدل چه تفاوتهایی دارن، قیمتگذاریشون چطوره، و چرا اوپنایآی الان تو یه وضعیتِ عجیب گیر کرده.
معرفی سه مدل GPT 5.6: سول، ترا و لونا
مدل GPT 5.6 شامل سه گزینه میشن: سول بهعنوان بزرگترین و پیشرفتهترین مدل برای وظایف پیچیده و حرفهای، ترا بهعنوان یه مدل متوسط و کاربردی برای کارهای روزمره، و لونا بهعنوان کوچکترین و سریعترین گزینه برای وظایف ساده. این سهتایی شبیه به همون سیستمی هستن که Anthropic با مدلهای هایکو، سونت و اوپوس داره، ولی با یه تفاوت: اوپنایآی داره تلاش میکنه بهجای اینکه یک دونه مدل قوی داشته باشه که همهجا از دستش استفاده کنن، راهِ بهینهتری برای توسعهدهندگان و کارآفرینان پیدا کنه.
سول واسه چیه؟ اگه داری روی یه پروژهی تحقیقاتی کار میکنی، یا میخوای یه کدِ پیچیده بنویسی که نیاز به استدلال و تفکرِ عمیق داره، سول بهترین انتخابه. این مدل میتونه واسه تحلیلهای چندمرحلهای، طراحی معماری نرمافزار، یا حتی تولیدِ محتوای خیلی تخصصی بهکارت بیاد.
ترا چطور؟ این مدل وسطیه. نه خیلی گرون، نه خیلی ساده. میخوای یه چتبات باهوش بسازی؟ میخوای یه سیستمِ اتوماسیونِ متوسط راه بندازی؟ ترا دقیقاً همون چیزیه که نیاز داری. سرعتش معقوله، توانش کافیه، و قیمتش عاقلانهست.
لونا واسه چی؟ تصور کن میخوای یه سیستمِ پاسخدهی سریع بسازی که هزاران بار در ساعت فراخوانی میشه. لونا دقیقاً همون چیزیه که نیاز داری. سریعه، ارزونه، و واسه وظایفی که نیاز به استدلالِ سنگین ندارن بینظیره.
این تقسیمبندی یه چیز دیگه رو هم نشون میده: اوپنایآی داره بهصورت جدی روی بهینهسازیِ هزینه برای توسعهدهندگان تمرکز میکنه. قبلاً میدیدیم که شرکتهای کوچیک مجبور بودن همون مدل گرون رو واسه هر کاری استفاده کنن، حالا میتونن مدل مناسب رو انتخاب کنن و بودجهشون رو بهتر مدیریت کنن.
قیمتگذاری مدل GPT 5.6 و مقایسه هزینهها
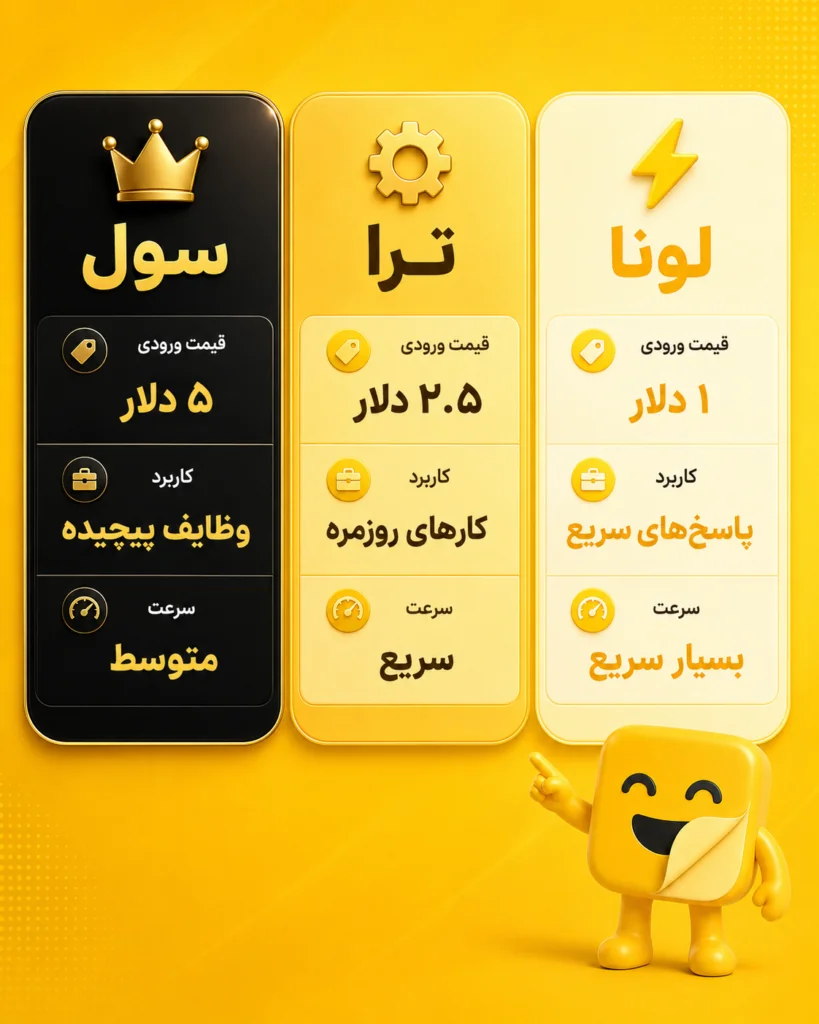
بهروزرسانی ۳۰ ژوئیهٔ ۲۰۲۶: نرخهای API متنِ Terra به ۲/۱۲ و Luna به ۰٫۲/۱٫۲ دلار برای میلیون توکن ورودی/خروجی کاهش یافت؛ Sol در مقایسهٔ مورد اشاره ۵/۳۰ موند. این نرخ API با قیمت اشتراک ChatGPT یکی نیست.
بذار سادهتر توضیح بدم. فرض کن داری یه استارتاپ میسازی که روزی ۱۰۰ هزار درخواست از کاربرا میگیره. اگه سول رو برای همه استفاده کنی، هزینهات میتونه تا پنج برابر لونا بشه. ولی اگه لونا رو واسه سؤالات ساده و سول رو فقط واسه موارد پیچیده بهکار ببری، میتونی همون عملکرد خوب رو با هزینهی کمتری بگیری.
| مدل | قیمت ورودی (میلیون توکن) | قیمت خروجی (میلیون توکن) | کاربرد اصلی |
|---|---|---|---|
| سول | ۵ دلار | ۳۰ دلار | کدنویسی پیشرفته، تحقیق |
| ترا | ۲ دلار | ۱۲ دلار | کاربردهای روزمره و متوسط |
| لونا | ۰٫۲ دلار | ۱٫۲ دلار | وظایف سریع و ساده |
یه نکتهی جالب اینجاست: فاصلهی قیمتی بین این مدلها نشوندهندهی این چیزه که اوپنایآی داره میخواد توسعهدهندگان رو وادار کنه که دقیقتر فکر کنن. تو یه نرمافزارِ واقعی، همهی وظایف یه سطح اهمیت ندارن. یه سیستمِ چتبات ممکنه ۸۰ درصد سؤالات رو بتونه با لونا جواب بده، ۱۵ درصد رو با ترا، و فقط ۵ درصد رو با سول. این ترکیب میتونه باعث بشه هزینهی کلیات تا ۶۰ درصد کاهش پیدا کنه.
مقایسه با مدلهای Anthropic هم جالبه. مدلهای هایکو، سونت و اوپوس Anthropic دقیقاً همین استراتژی رو دارن، ولی تفاوتش اینه که Anthropic قبل از اوپنایآی این مسیر رو رفت و حالا داره با محدودیتهای دولتی سر و کله میزنه. اوپنایآی یاد گرفته که عجله نکنه.
رقابت مدلهای چینی و فشار قیمتی بر بازار
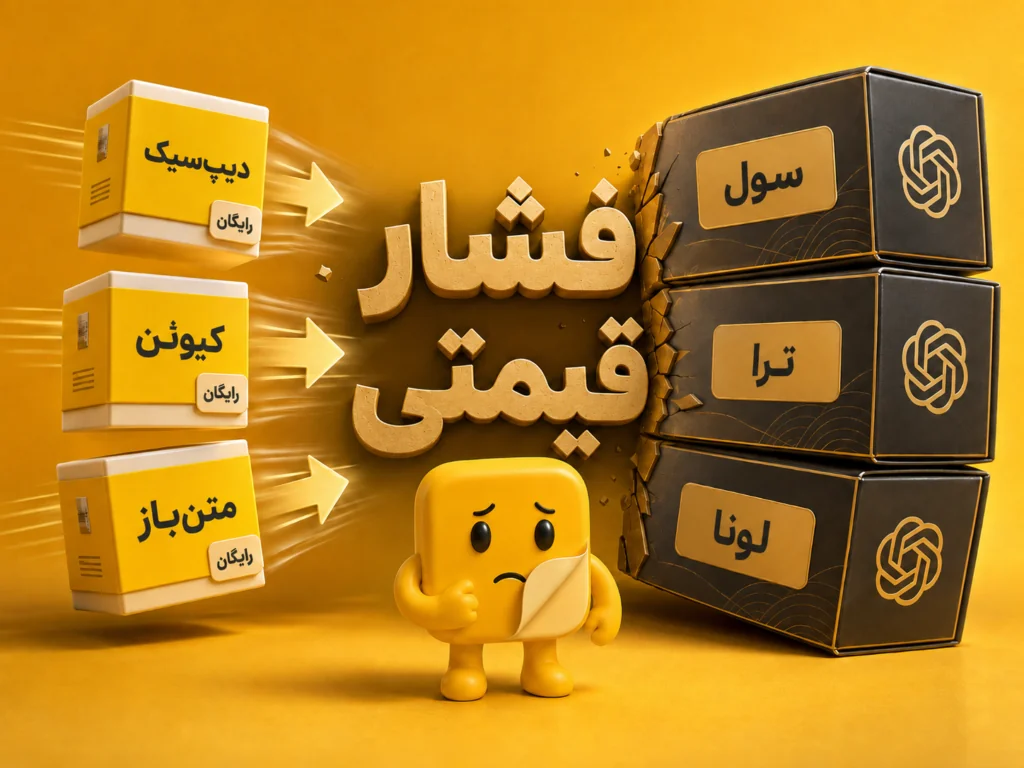
رقابت مدل GPT 5.6 با مدلهای چینی دیگه یه بازیِ هوش محض نیست، بلکه یه مسابقهی اقتصادیه. مدلهای چینی مثل Deepseek، Qwen، Kimi و GLM دارن تو بازار تکون میخورن و اوپنایآی رو تحت فشار میذارن. این مدلها نه تنها ارزونترن، بلکه رایگان و متنبازن. یعنی هرکسی میتونه بدون پرداخت حتی یک دلار، ازشون استفاده کنه.
چرا این فشار قیمتی مهمه؟ چون الان شرکتهای آمریکایی مثل اوپنایآی و Anthropic نمیتونن فقط با افزایشِ قدرتِ مدلهاشون بازار رو حفظ کنن. اگه یه استارتاپ ایرانی بتونه یه مدلِ چینی رایگان رو پیادهسازی کنه و عملکردِ قابلقبولی بگیره، دیگه چرا باید ماهی چند صد دلار برای GPT 5.6 خرج کنه؟
این مدلهای چینی کاراییشون هم بیشتر شده. مثلاً Deepseek V3 که اوایل سال ۲۰۲5 منتشر شد، توی بعضی بنچمارکها خیلی نزدیک به GPT 5 رسیده. البته هنوز فاصله داره، ولی فاصلهای که هر روز کوچیکتر میشه.
یه نگرانیِ جدی هم وجود داره: اگه چین بتونه به سطحِ فرانتیر برسه، احتمالاً دیگه مدلهاش رو رایگان منتشر نمیکنه. الان سیاست متنباز چین به این دلیله که میخوان بازار رو تصرف کنن و شرکتهای آمریکایی رو ضعیف کنن. وقتی خودشون به جایگاهِ اول برسن، احتمالاً همون مسیرِ تجاری رو میرن که اوپنایآی رفته.
واسه توسعهدهندگان و کارآفرینان ایرانی این یعنی چی؟ یعنی اگه الان داری روی یه پروژه کار میکنی و میخوای بلندمدت روی یه مدل متکی باشی، فقط به قیمتِ امروز نگاه نکن. ببین کدوم مدل واقعاً زیرساخت و کیفیت بلندمدت رو داره.
🎯 اشتراک ChatGPT رو از کادینر بگیر!
اکانت اختصاصی و قانونی روی ایمیل خودت، تحویل زیر چهار ساعت و گارانتی تا پایان اشتراک.
🛡 گارانتی تا پایان اشتراک
💬 پشتیبانی فارسی
مزیت زیرساختی آمریکا: تراشه Cerebras و سرعت استنتاج
در معرفی اولیهٔ مسیر Cerebras، سرعت تا ۷۵۰ توکن در ثانیه برای مشتریان منتخب مطرح شد. این عدد به همون مسیر سرویس مربوطه؛ زمان کامل پاسخ شامل صف، ابزار و طول درخواست هم میشه.
از ژوئیه ۲۰۲۶، مدلِ سول قراره روی تراشهی Cerebras هم در دسترس باشه. این یک گامِ بزرگه، چون نشون میده اوپنایآی فقط داره روی لایهی مدل تمرکز نمیکنه، بلکه داره زیرساخت و استنتاج رو هم جدی میگیره.
سرعت استنتاج به سختافزار، مدل، تنظیمات اجرا و بار سرویس وابستهست. برای مقایسهٔ دو ارائهدهنده، تأخیر اولین توکن و زمان کامل همان درخواست رو جدا بسنج.
این برتری تو لایهی زیرساختی واسه توسعهدهندگان اهمیت زیادی داره. خیلی وقتها مسئله فقط اینکه مدل چقدر باهوشه نیست، بلکه اینکه چقدر سریع جواب میده. اگه داری یه سرویسِ خدماتیِ لحظهای میسازی، حتی چند ثانیه تأخیر میتونه باعث بشه کاربرها ول کنن برن.
چالشهای قانونی و مقررات دولتی برای GPT 5.6
بندهای ۳(b) و ۳(c) دستور اجرایی ۲ ژوئن ۲۰۲۶، چارچوب داوطلبانه رو توصیف میکنن و مجوز یا پیشتأیید اجباریِ تازهای برای انتشار همهٔ مدلها ایجاد نمیکنن. پس توقف عمومی تا تأیید دولت، برداشت درست این سند نیست.
روایت اختلاف Anthropic و دولت رو بدون سند اصلی و دامنهٔ دقیق، دلیل توقف عمومی همهٔ مدلها قرار نمیدیم. محدودیت یک محصول یا همکاری یک شرکت، قاعدهٔ حقوقی یکسان برای تمام عرضهها نمیسازه.
فرایند همکاری داوطلبانهٔ شرکت با دولت رو باید با سند و بازهٔ زمانی خودش توضیح داد. از اون نمیشه دربارهٔ انگیزهٔ شرکت یا توقف الزامی همهٔ عرضهها حکم یکسان داد.
همکاری داوطلبانه، دستور الزامآور و شرط دسترسی محصول سه موضوع جدا هستن. سند مورد اشاره بهخودیخود اثبات نمیکنه که انتشار هر مدل پیشرفته به مجوز قبلی دولت وابسته شده.
موضعِ اوپنایآی اما روشنه: این شرکت معتقده که این فرآیند نباید بلندمدت باشه و قدرت باید دستِ کاربران و بازار باشه، نه فقط دولت.
به روزرسانی 20 تیر ماه 1405:
در این تاریخ هم مدل fable 5 از Anthropic هم مدل chat GPT 5.6 از Open AI در دسترس عموم مردم هستن و فقط کافیه برای دسترسی بهشون اشتراک بخری.
خرید اشتراک Chat GPT
خرید اشتراک Claude
آینده بازار مدلهای هوش مصنوعی: فشارهای دوگانه
بازارِ مدل GPT 5.6 الان تو یه وضعیتِ دوگانهی خاصی قرار داره. از یک طرف، فشارِ رو به بالا از سمتِ مدلهای چینی که هر روز قویتر و ارزونتر میشن، و از طرف دیگه فشارِ رو به پایین از سمتِ مقرراتِ دولتی که سرعت انتشار و دسترسی رو محدود میکنه. این دو فشار دارن اوپنایآی و Anthropic رو بهسمتِ یه وضعیتِ سخت میبرن.
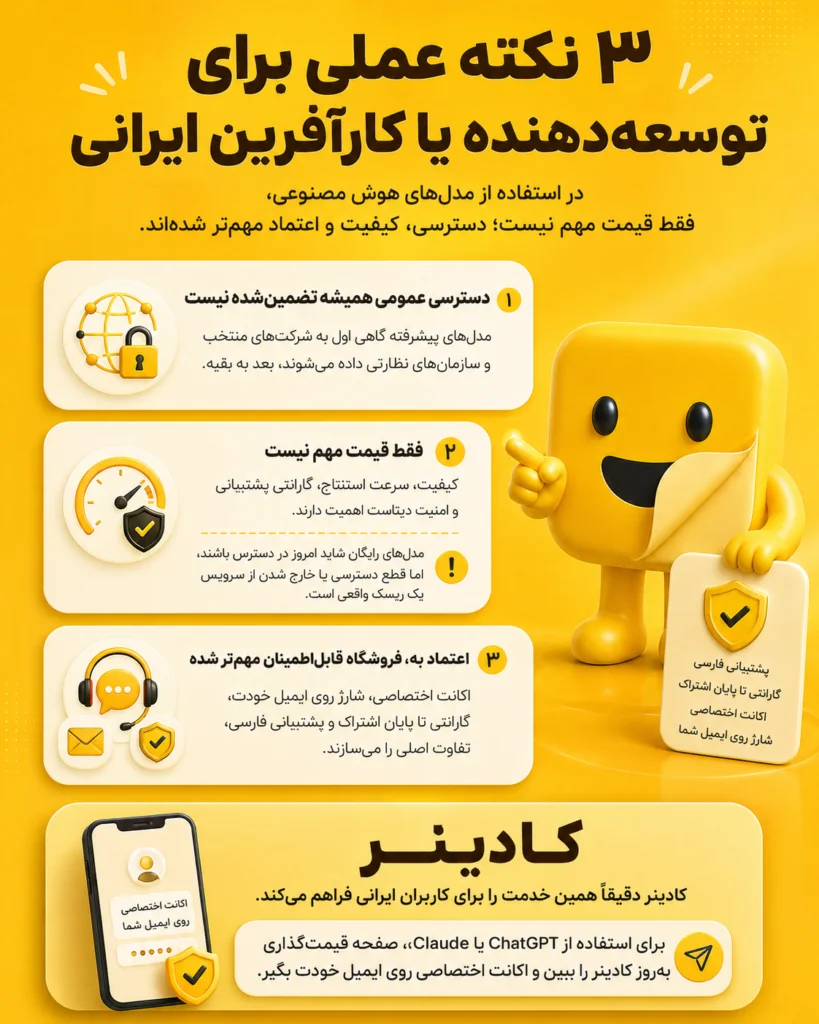
اگه یه توسعهدهنده یا کارآفرین ایرانی باشی، این واقعیت یعنی چند تا نکته عملی:
اولاً، دیگه نمیتونی فرض کنی که توکنهای هوشمند همیشه در دسترسِ عمومی باشن. دارن خصوصیتر و محدودتر میشن. الان اوپنایآی داره مدلهای پیشرفتهاش رو اول به شرکتهای منتخب و سازمانهای نظارتی میده، بعد به بقیه.
ثانیاً، قیمتها هرچقدر هم پایین بیان، مسئله فقط قیمت نیست. موضوع کیفیت، سرعت استنتاج، گارانتی پشتیبانی و امنیتِ دیتاست. مدلهای چینی شاید رایگان باشن، ولی اگه یه روز دسترسیت قطع بشه یا مدل به هر دلیلی از دسترس خارج بشه، هیچ مسئولیتی نداری که دنبالش بگردی.
ثالثاً، تو این شرایط اعتماد به یه فروشگاه قابلاطمینان اهمیت بیشتری پیدا میکنه. جایی که بهت اکانتِ اختصاصی بده، روی ایمیلِ خودت شارژ بشه، گارانتی تا پایانِ اشتراک داشته باشه، و پشتیبانیِ فارسی بگیری. کادینر دقیقاً همین خدمت رو واسه کاربرهای ایرانی فراهم میکنه.
برای استفاده از مدلهای هوش مصنوعی مثل ChatGPT یا Claude، میتونی به صفحهی قیمتگذاری بهروز این سرویسها تو کادینر مراجعه کنی و اکانتِ اختصاصی روی ایمیلِ خودت بگیری.
سوالات متداول
تفاوت مدلهای سول، ترا و لونا در GPT-5.6 چیست؟
سول قدرتمندترین مدل برای کدنویسی و تحقیق پیشرفته با قیمت ۵ دلار ورودی است. ترا برای کاربردهای روزمره با قیمت ۲.۵ دلار مناسب است و لونا سریعترین گزینه برای وظایف ساده با قیمت ۱ دلار به ازای میلیون توکن ورودی طراحی شده است.
قیمت استفاده از ChatGTP 5.6 چقدر است؟
نرخهای نسخهٔ معرفی، تاریخی هستن. از ۳۰ ژوئیه، مقایسهٔ جاریِ همون سه مدل باید Terra و Luna رو با نرخ کاهشیافته حساب کنه؛ API، اشتراک چت و میزبانی مستقل هم هزینههای متفاوتی دارن.
چرا ChatGTP 5.6 هنوز به صورت عمومی منتشر نشدهاند؟
فرض سؤال با یادداشت دسترسی عمومیِ همین مقاله سازگار نیست. دستور اجرایی مورد اشاره هم پیشتأیید اجباری عمومی ایجاد نمیکنه؛ باید شرایط عرضهٔ هر مدل و مسیر استفاده رو جدا از چارچوب داوطلبانهٔ همکاری دولت و شرکتها توضیح داد.
مدلهای چینی چه تهدیدی برای GPT-5.6 محسوب میشوند؟
مدلهای چینی مانند Deepseek و Quen با قیمت بسیار پایینتر و انتشار رایگان به صورت متنباز، فشار رقابتی شدیدی بر اوپنایآی وارد کردهاند. این شرکتها توانستهاند کارایی مدلهای خود را افزایش دهند، هرچند هنوز در سرعت استنتاج به آمریکا نرسیدهاند.
مزیت تراشه Cerebras در ChatGTP 5.6 چیست؟
تراشه Cerebras میتواند سرعت استنتاج را تا ۷۵۰ توکن در ثانیه برساند که برتری زیرساختی آمریکا در برابر چین است. از جولای ۲۰۲۶، مدل سول روی این تراشه عرضه میشود و این سرعت بالا در کاربردهای real-time و تعاملی اهمیت حیاتی دارد.
آینده بازار مدلهای هوش مصنوعی با GPT-5.6 چگونه است؟
بازار تحت دو فشار متضاد قرار دارد: از پایین، مدلهای ارزان چینی قیمتها را کاهش میدهند و از بالا، مقررات دولتی دسترسی را محدود میکنند. این وضعیت منجر به خصوصیسازی فزاینده مدلهای پیشرفته و دسترسی اولویتدار شرکتهای منتخب خواهد شد.
آیا ChatGTP 5.6 برای همه در دسترسند؟
دسترسی به مدل به محصول، پلن، منطقه و مرحلهٔ عرضه وابستهست. مسیر Cerebras در معرفی اولیه برای مشتریان منتخب عرضه شد؛ وضعیت اون مسیر رو جدا از API استاندارد و ChatGPT در نظر بگیر.
تفاوت اصلی سول، ترا و لونا چیه؟
Sol برای کارهای پیچیدهتر، Terra برای مسیر متعادل و Luna برای کارهای سبکتر معرفی شدن. هزینهٔ هر کار پذیرفتهشده رو با ورودی، خروجی و تلاشهای اصلاح حساب کن.
چرا مدلهای چینی ارزونترن؟
چون دولتِ چین از بخش خصوصی حمایتِ مالی میکنه و مدلها رو رایگان و متنباز عرضه میکنه تا بازار رو تصرف کنه. ولی کیفیت و سرعت استنتاج هنوز به سطح مدلهای آمریکایی نرسیدن.
تراشه Cerebras چه کمکی به ChatGTP 5.6 میکنه؟
این تراشه میتونه سرعتِ تولید توکن رو تا ۷۵۰ توکن در ثانیه برسونه، که باعث میشه استفاده از مدلها توی برنامههای واقعی بسیار سریعتر و روانتر بشه.
آیا اوپنایآی در آینده مجبور میشه قیمتها رو کاهش بده؟
احتمالش هست، بهخصوص با فشار مدلهای چینی. ولی احتمالاً بهجای کاهش قیمت خودِ مدلها، اوپنایآی روی ارائه مدلهای متنوعتر و بهینهتر تمرکز میکنه که کاربران بتونن هزینهشون رو بهتر مدیریت کنن.

هنوز دیدگاهی برای این محصول ثبت نشده است.