
GPT 6 Sol چیه و چه فرقی با GPT 6 Luna داره؟

GPT 6 Sol چیه و چه فرقی با GPT 6 Luna داره؟
اگه این روزها اخبار هوش مصنوعی رو دنبال میکنی، احتمالاً به اسم GPT 6 Sol و GPT 6 Luna برخوردهای و از خودت پرسیدی کدومشون به کار تو میاد. این دو مدل قرار نیست جایگزین هم باشن؛ هر کدوم برای یک نوع کار طراحی شدن. GPT 6 Sol سمت کارهای پیچیده و چندمرحلهای میایسته و GPT 6 Luna برای حجم بالا و سرعت ساخته شده. توی این مقاله میخوایم دقیق ببینیم فرق این دو مدل چیه، کدوم برای برنامهنویسی و تولید محتوا مناسبتره، هزینه و محدودیتهاشون چطوره، و در نهایت از کجا میشه بهشون دسترسی پیدا کرد.برای مقایسهٔ بهتر مدلهای سول و لونا میتونی مدل GPT 5.6: مقایسه سول، ترا و لونا و چالشهای رقابتی رو هم بخونی.
OpenAI مشخصات فنی، قیمت API و نتایج چند بنچمارک GPT 6 Sol و GPT 6 Luna رو رسماً منتشر کرده. پایینتر هم عددهای مهم رو با منبع و توضیح روش خواندنشون میبینی. این نتایج به شرایط همان آزمونها مربوطاند و قیمت و دسترسی ممکنه بعداً تغییر کنن؛ برای تصمیم نهایی، صفحه رسمی مدلها رو هم بررسی کن.
Sol و Luna برای چه کارهایی بهترن؟
GPT 6 Sol مدل حرفهای خانواده GPT 6 هست که برای موارد استفاده GPT 6 Sol مثل برنامهنویسی، عاملهای چندمرحلهای و تحلیل پیچیده ساخته شده؛ GPT 6 Luna هم مدل اقتصادیتریه که برای کارهای سریع، پرتعداد، طبقهبندی، استخراج داده و پشتیبانی طراحی شده. این تفکیک یعنی وقتی کار سنگین و چندمرحلهای داری، سمت Sol بری بهتره؛ وقتی حجم بالا و ساده داری، Luna جواب میده.
فرض کن قراره یک کدبیس بزرگ رو تحلیل کنی، دنبال منشأ یک باگ پیچیده بگردی یا چند فایل بههموابسته رو همزمان تغییر بدی. این دقیقاً همون نوع کاریه که Sol براش ساخته شده؛ چون نیاز به استدلال عمیق و دنبالکردن زنجیرهای از منطق داره.
از طرف دیگه، اگه قراره صدها تیکت پشتیبانی رو دستهبندی کنی، از یک انبوه سند داده استخراج کنی یا پاسخهای کوتاه و تکراری تولید کنی، Luna گزینه منطقیتریه. این کارها معمولاً پیچیدگی استدلالی بالایی نمیخوان، ولی حجمشون زیاده و سرعت پاسخ اهمیت داره.
- Sol: تحلیل کدبیس، دیباگ چندمرحلهای، طراحی معماری، تحقیق عمیق
- Luna: دستهبندی تیکت، استخراج داده از سند، پاسخ سریع به سؤالات ساده، پردازش حجم بالا
تفاوت GPT-6 Sol و GPT-6 Luna چیه؟
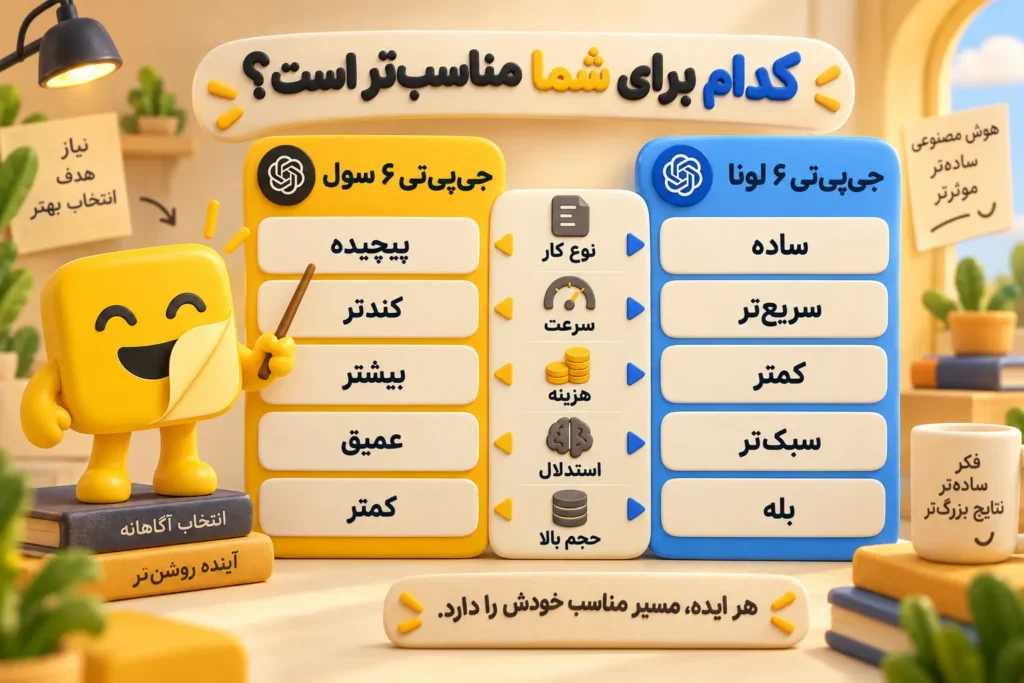
تفاوت Sol و Luna در جایگاه کاری، سطح پیچیدگی، سرعت و هزینه استفادهست. Sol برای کیفیت و استدلال در کارهای پیچیدهتر طراحی شده و Luna برای حجم بالا، پاسخ سریع و هزینه کمتر. این یعنی وقتی میخوای بین این دو انتخاب کنی، باید اول ببینی کارت به عمق فکری بیشتری نیاز داره یا به سرعت و تعداد بیشتر.
| معیار | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| نوع کار مناسب | پیچیده، چندمرحلهای، حرفهای | ساده، تکراری، پرتعداد |
| سرعت پاسخ | معمولاً کندتر | معمولاً سریعتر |
| هزینه هر درخواست | بیشتر | کمتر |
| نیاز به استدلال عمیق | بالا | پایین تا متوسط |
| مناسب برای حجم بالا | نه لزوماً | بله |
نکتهای که این وسط باید حواست بهش باشه اینه که «گرونتر بودن» بهمعنای «همیشه بهتر بودن» نیست. اگه کارت ساده و تکراریه، استفاده از Sol فقط هزینه رو بالا میبره بدون اینکه فایده محسوسی اضافه کنه. برعکسش هم صادقه؛ اگه کار پیچیده رو به Luna بسپاری، ممکنه نتیجه دقیق و قابلاعتماد نباشه.
برای برنامهنویسی و تولید محتوا کدوم مدل مناسبتره؟
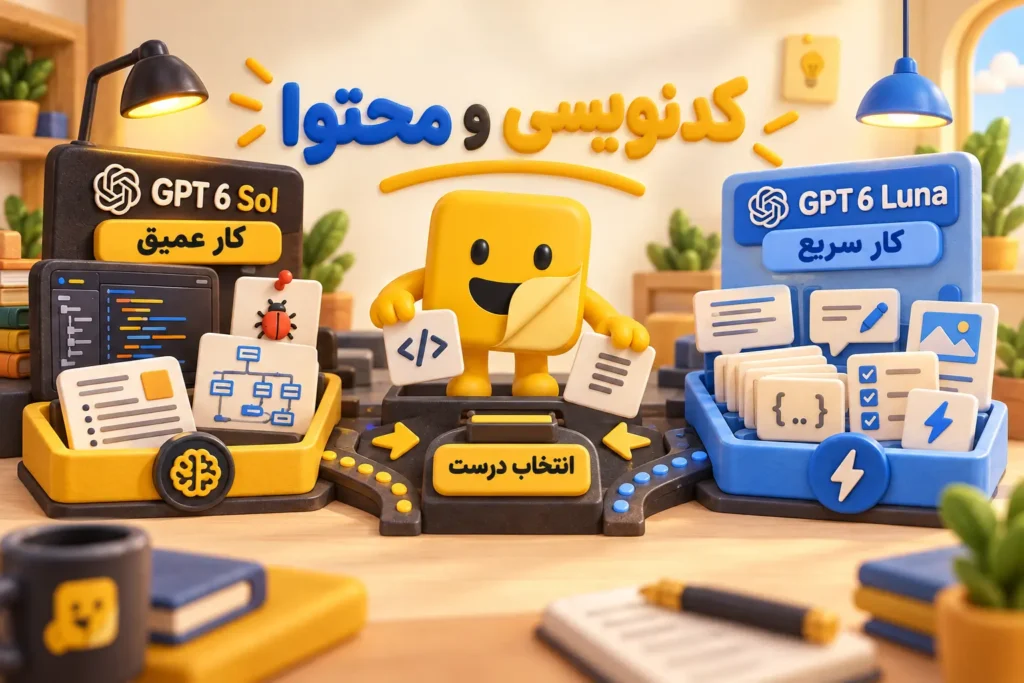
برای برنامهنویسی، Sol برای پیدا کردن منشأ باگ، تغییر فایلهای لازم، نوشتن تست و بررسی اثر تغییر مناسبتره؛ Luna بیشتر برای کدهای تکراری و تحلیل اولیه خطاها به کار میاد. برای تولید محتوا هم انتخاب مدل به پیچیدگی و حساسیت متن بستگی داره.برای اطلاعات بیشتر در این مورد میتونی ChatGPT Work چیست؟ راهنمای کامل مدلهای Sol و Terra و Luna ؛ تیر 1405 رو ببینی.
اگه بهعنوان برنامهنویس داری روی یک ویژگی جدید کار میکنی که چند بخش از سیستم رو تحت تأثیر قرار میده، Sol بهتر میتونه رابطه بین این بخشها رو دنبال کنه و راهحلی بده که واقعاً کار کنه. اما اگه فقط میخوای یک تابع ساده بنویسی یا خطای واضحی رو پیدا کنی، Luna معمولاً سریعتر و کمهزینهتر همون نتیجه رو میده.
برای تولید کنندههای محتوا هم داستان مشابهه. اگه قراره یک مقاله تحلیلی عمیق بنویسی که نیاز به ساختاردهی پیچیده و ارجاع منطقی بین بخشها داره، Sol گزینه معقولتریه. اما برای تولید عناوین، خلاصهسازی متنهای کوتاه یا تولید حجم بالای محتوای ساده، Luna میتونه سریعتر جواب بده.
نکته مهم اینجاست که برای تولید محتوا، قبل از انتخاب مدل باید زمینه، معیار پذیرش و قالب خروجی رو دقیق مشخص کنی. اگه اینها روشن نباشن، حتی قویترین مدل هم ممکنه خروجی نامناسب بده. یعنی کیفیت درخواست تو، گاهی از انتخاب مدل هم مهمتره.
نتایج بنچمارکها و پیشرفتهای Sol و Luna چی میگن؟
OpenAI در معرفی رسمی GPT 6 Sol و Luna چند نتیجه از کار حرفهای، کدنویسی و کار با رایانه منتشر کرده. این عددها به سؤال «مدل در آزمون مشخص چقدر خوب عمل کرده؟» جواب میدن، ولی بهتنهایی نمیگن روی فایلها، ابزارها و درخواستهای تو هم همان امتیاز رو میگیره. سطح تلاش استدلالی یا effort و هزینهٔ هر وظیفه رو هم باید کنار امتیاز ببینی.
کار حرفهای و استفاده از ابزارها چقدر بهتر شده؟
در AutomationBench 1.0.6، عاملهای هوش مصنوعی باید جریانهای کاری چندمرحلهای رو با ۴۷ ابزار در حوزههایی مثل فروش، پشتیبانی و عملیات انجام بدن. GPT 6 Sol با effort سطح xhigh امتیاز ۳۳٫۲ درصد و هزینهٔ ۰٫۲۷ دلار برای هر وظیفه ثبت کرده. OpenAI میگه GPT 6 Luna با effort سطح high نسبت به GPT 5.6 Luna، ۵٫۴ واحد درصد امتیاز بالاتر و ۵۸ درصد هزینهٔ کمتر برای هر وظیفه داشته. «واحد درصد» با «درصد رشد نسبی» فرق داره؛ این عدد اختلاف مستقیم دو امتیازه.
در Agents’ Last Exam، که وظایف حرفهای طولانیتر رو در رشتهها و صنایع مختلف میسنجه، Sol با effort سطح max به امتیاز ۵۶٫۴ درصد رسیده. این نتیجه برای کسی مهمه که میخواد مدل فقط یک جواب کوتاه نده و چند مرحله کار رو با ابزارها جلو ببره. البته امتیاز ۵۶٫۴ درصد خودش نشان میده حتی در همین آزمون هم بخش قابلتوجهی از وظایف کامل حل نشدهاند؛ پس برای کار حساس، خروجی عامل همچنان به بررسی نیاز داره.
برای کدنویسی و کار با رایانه چه نتیجهای منتشر شده؟
در FrontierCode، فقط اجرای درست کد مهم نیست؛ کیفیت تست، محدودهٔ تغییر و آمادهبودن آن برای ادغام در پروژه هم بررسی میشه. OpenAI میگه Sol در این آزمون نسبت به GPT 5.6 Sol پیشرفت قابلتوجهی داشته. در DeepSWE v1.1، که روی وظایف طولانی مهندسی نرمافزار در کدبیسهای واقعی تمرکز داره، Sol با effort سطح max امتیاز ۶۸٫۸ درصد و Luna با همان سطح effort امتیاز ۶۶٫۶ درصد گرفتهاند. این نتیجه نشان میده Luna هم در یک آزمون کدنویسی پیچیده توان رقابتی داشته؛ با این حال، برای انتخاب مدل پروژهات باید کیفیت تست و هزینهٔ اجرای خودت رو بسنجی.
در OSWorld 2.0 offline، که عاملها باید با محیط رایانه کار کنن، Sol با effort سطح xhigh امتیاز ۶۰٫۵ درصد گرفته. OpenAI همچنین گزارش کرده Luna با effort سطح max از GPT 5.6 Sol با effort سطح medium و حدود یکدهم هزینهٔ هر وظیفه جلو زده. معیار منتشرشده برای OSWorld امتیاز جزئی روی مجموعهٔ آفلاین است؛ بنابراین نباید آن رو معادل نرخ موفقیت کامل در کار روزانه با مرورگر یا فایلسیستم بدونی.
دقت پاسخ و رفتار مدلها هم تغییر کرده؟
OpenAI در یک ارزیابی داخلی از گفتوگوهای ناشناسشدهای که کاربران قبلاً در آنها خطای واقعی گزارش کرده بودند، میگه Sol حدود نصف GPT 5.6 Sol اشتباه کرده. Luna هم در سطحهای بالاتر effort پیشرفت داشته. خود OpenAI توضیح میده این گفتوگوهای خطاخیز نمایندهٔ استفادهٔ معمول نیستن؛ بنابراین این نتیجه به معنی «نصفشدن خطا در هر کار» یا بینیازی از منبع و بازبینی نیست.
پیشرفت فقط به امتیاز آزمونها محدود نیست. OpenAI میگه در Sol و Luna، گزارش کار فنی شفافتر شده و نرخ ادعاهای گمراهکننده دربارهٔ کار کدنویسی نسبت به مدلهای GPT 5.6 پایینتر اومده. کشِ بهتر زمینه هم میتونه بخشهای تکراری درخواستهای طولانی رو سریعتر و با هزینهٔ کمتر پردازش کنه؛ تخفیف خواندن ورودی کششده ۹۰ درصده. برای یک عامل کدنویسی یا پشتیبانی، این یعنی باید هم کیفیت نتیجه، هم صداقت گزارش انجام کار و هم هزینهٔ کل گردش کار رو اندازه بگیری.
برای تفسیر درست این آمار، به سه چیز دقت کن: امتیاز آزمون، سطح effort و هزینهٔ هر وظیفه. نتایج OpenAI در محیط پژوهشی یا از طریق API به دست اومدهاند و ممکنه با خروجی محصول نهایی بهخاطر تفاوت ابزارها و دستورالعملها کمی فرق داشته باشن. پس یک مجموعهٔ کوچک از کارهای واقعی خودت بساز و Sol و Luna رو با همان ورودیها و معیار پذیرش مقایسه کن؛ این کار از تکیهٔ صرف به یک عدد بنچمارک دقیقتره.
خرید اشتراک قانونی و اختصاصی برای استفاده پایدارتر
اشتراکهای اختصاصی کادینر روی ایمیل شخصی خود کاربر، همراه با گارانتی و پشتیبانی کامل ارائه میشوند.
چطور مدل مناسب رو برای هر درخواست انتخاب کنیم؟
برای انتخاب مدل مناسب، اول باید مسئله، هدف، محدودیتها و داده قابلاعتماد رو مشخص کنی. بعد درخواست رو ابتدا با Luna بررسی کن و اگه پاسخش کافی نبود یا کار پیچیدهتر از حد معمول بود، به Sol منتقلش کن.
این رویکرد، یک الگوی عملی برای صرفهجویی در هزینه و زمانه:
- 1کار رو تعریف کن: چه نوع خروجی میخوای، چقدر پیچیدگی داره و چند مرحله لازمه؟
- 2اول با Luna امتحان کن، مخصوصاً اگه حجم درخواستها بالاست.
- 3اگه خروجی Luna دقت کافی نداشت یا نیاز به استدلال چندمرحلهای بود، به Sol برو.
- 4برای تصمیمهای حساس یا غیرقابلبرگشت، یک لایه بازبینی انسانی یا مدلهای دقیقتر مثل Astra رو هم وارد کن.
- 5نتیجه رو با نمونههای واقعی مقایسه کن؛ دقت، زمان پاسخ، effort و هزینه کل رو کنار هم بذار.
نکته آموزشی: تصمیم بین Sol و Luna نباید فقط بر اساس «کدوم مدل جدیدتره» گرفته بشه. معیار واقعی، تطابق پیچیدگی کار با توان مدله؛ یک مدل قویتر لزوماً برای هر کاری بهترین انتخاب نیست.
برای تصمیمهای حساس ( مثل کارهایی که روی داده مالی، تصمیمهای حقوقی یا هر چیزی که برگشتناپذیره تأثیر میذارن ) بهتره یک لایه بازبینی انسانی همیشه وجود داشته باشه، فارغ از اینکه از Sol استفاده کردی یا Luna.
هزینه، ابزارها و محدودیتهای Sol و Luna
طبق مشخصات رسمی مدلها و صفحهٔ قیمت API، هزینهٔ GPT 6 Sol برای هر یک میلیون توکن ورودی ۲ دلار و خروجی ۱۰ دلاره؛ برای GPT 6 Luna این عددها بهترتیب ۰٫۱۰ و ۰٫۵۰ دلارن. هر دو پنجرهٔ زمینهٔ ۱٫۰۵ میلیون توکن و سقف خروجی ۱۲۸ هزار توکن دارن و از ورودی تصویری، متن چندزبانه و ابزارهایی مثل جستوجو و فراخوانی تابع پشتیبانی میکنن. اینها قیمت API هستن، نه قیمت اشتراک کادینر یا سهمیهٔ پیام در یک پلن ChatGPT؛ برای تغییرات بعدی، صفحهٔ رسمی رو بررسی کن.
چیزی که مهمتر از عدد دقیقه، اینجاست که پنجره زمینه بزرگ بهتنهایی فهم بینقص یا نتیجه بهتر رو تضمین نمیکنه. یک مدل ممکنه پنجره زمینه بزرگی داشته باشه ولی هنوز توی دنبالکردن رابطه بین بخشهای دور از هم متن دچار خطا بشه. برای همین توصیه میشه بهجای تکیه صرف روی مشخصات فنی، روی نتیجه واقعی تست تمرکز کنی.
نکته دیگهای که باید حواست بهش باشه، استفاده از ابزارها و رایانه (مثل اجرای کد یا دسترسی به فایلسیستم) هست. این نوع قابلیتها به ثبت رویداد، محدودیت دسترسی و امکان توقف نیاز دارن. یعنی اگه داری از این مدلها برای کارهایی استفاده میکنی که به سیستم واقعی دسترسی دارن، باید مطمئن بشی که یک مکانیزم برای توقف یا محدودکردن دامنه دسترسی وجود داره.
قبل از انتخاب نهایی، این چکلیست میتونه کمکت کنه:
- آیا قیمت هر درخواست با حجم کاری که داری، منطقی درمیاد؟
- آیا سقف پنجره زمینه و خروجی برای پروژه تو کافیه؟
- آیا ابزارهایی که نیاز داری (مثل ورودی تصویری یا اجرای کد) در دسترسن؟
- آیا برای کارهای حساس، یک لایه بازبینی انسانی در نظر گرفتی؟
چطور درخواست مؤثر و کنترلشده بنویسیم؟
نوشتن یک درخواست خوب، گاهی تأثیرش روی نتیجه بیشتر از انتخاب مدله. هدف، زمینه، محدودیتها و داده معتبر رو واضح بنویس؛ هرچی این بخش مبهمتر باشه، احتمال خطا در خروجی بیشتر میشه.
در کنارش باید ابزارهای مجاز و شکل خروجی رو هم مشخص کنی. مثلاً اگه میخوای خروجی به فرمت JSON باشه یا فقط از یک ابزار خاص استفاده بشه، این رو صریح بنویس. مدل نمیتونه چیزی رو حدس بزنه که تو مشخص نکردی.
معیار موفقیت و شرایط توقف هم باید از قبل روشن باشن. یعنی باید بدونی که خروجی چه شکلی باید باشه تا بگی «کار انجام شده»، و اگه مدل به بنبست خورد یا داده کافی نداشت، چه اتفاقی باید بیفته.
- هدف کار رو در یک جمله واضح بنویس
- زمینه لازم (داده، فایل، پیشزمینه) رو کامل ضمیمه کن
- ابزارهای مجاز و قالب خروجی مورد انتظار رو مشخص کن
- معیار پذیرش نهایی رو تعریف کن
- شرایط توقف یا نیاز به بازبینی انسانی رو مشخص کن
بعد از اجرای درخواست، نتیجه تستها و فرضهای باقیمانده رو گزارش کن. اگه بخشی از کار روی فرضهایی بنا شده که مطمئن نیستی درستن، اینها رو جداگانه علامتگذاری کن تا بعداً بتونی راحتتر پیگیریشون کنی.
مسیر دسترسی به Sol و Luna از کادینر
برای دسترسی به این خانواده از مدلها، معمولاً از طریق اکانتهای ChatGPT وارد میشی. کادینر عرضهکننده اکانتهای ChatGPT Plus، ChatGPT Go و ChatGPT Pro هست و میتونه مسیر عملی برای دسترسی به این پلنها باشه. انتخاب بین این پلنها به نوع استفاده، حجم کار و سطح دسترسی مورد نیازت بستگی داره؛ کسی که کار سبک و گاهبهگاه داره با کسی که هر روز روی پروژههای سنگین کار میکنه، نیاز متفاوتی داره. برای سؤالات مربوط به پلنها و فرایند تحویل هم میتونی از طریق تلگرام با پشتیبانی کادینر در تماس باشی.
خرید اشتراک قانونی و اختصاصی برای استفاده پایدارتر
اشتراکهای اختصاصی کادینر روی ایمیل شخصی خود کاربر، همراه با گارانتی و پشتیبانی کامل ارائه میشوند.
جمعبندی
انتخاب بین GPT-6 Sol و GPT-6 Luna به این برمیگرده که کارت چقدر پیچیدهست و چقدر حجم داری. برای تحلیل عمیق، برنامهنویسی چندمرحلهای و کارهای حرفهای، Sol گزینه منطقیتریه؛ برای طبقهبندی، استخراج داده و کارهای پرتکرار، Luna هزینه و زمان کمتری میبره. بهترین روش اینه که کار رو با نمونه واقعی تست کنی، هزینه کل رو در نظر بگیری و برای تصمیمهای حساس همیشه یک لایه بازبینی انسانی داشته باشی. جزئیات فنی و قیمتی این مدلها هم مدام در حال تغییرن، پس قبل از هر تصمیم نهایی حتماً سراغ منبع رسمی و تازه برو.
هنوز دیدگاهی برای این محصول ثبت نشده است.