خانه/Claude/Claude Opus 5.5 چیست و برای چه کارهایی ارزش استفاده داره؟
Claude 01 مهر 1405
Claude Opus 5.5 چیست و برای چه کارهایی ارزش استفاده داره؟
نوشته: امیرعلی قربانی
Claude Opus 5.5 چیست و برای چه کارهایی ارزش استفاده داره؟
اگه اخبار هوش مصنوعی رو دنبال میکنی، احتمالاً اسم Claude Opus 5.5 رو شنیدی؛ مدلی که Anthropic اون رو بهعنوان اولین عضو خانواده Claude 5.5 معرفی کرده. سؤال اصلی این نیست که این مدل قوی هست یا نه؛ سؤال اینه که برای کار تو – چه برنامهنویسی باشه، چه پژوهش، چه تولید محتوا – واقعاً به این سطح از قدرت نیاز داری یا یه مدل سریعتر و ارزونتر کارت رو راه میندازه. این مقاله معیارهای این تصمیم رو قدمبهقدم باز میکنه: از کاربردها و مشخصات فنی تا قیمت، عملکرد واقعی و مسیر مهاجرت.
Claude Opus 5.5 برای چه کارهایی مناسبه؟
Claude Opus 5.5 مدل پرچمدار Anthropic در خانواده تازه Claude 5.5 هست و طبق اعلام رسمی، نسبت به Opus 5 حدود ۴۰ درصد هزینه اجرایی کمتری داره. این مدل برای کارهایی طراحی شده که چند مرحله دارن و نیاز به تصمیمگیری پیوسته دارن، نه برای یک سؤال ساده و تکمرحلهای.
یک پرسش ساده مثل خلاصهکردن یک پاراگراف یا پاسخ به یک سؤال متنی، نیازی به قدرت پردازشی این سطح نداره. اما وقتی پروژه شامل چند مرحله متوالیه – مثلاً باید کد بنویسه، نتیجه رو تست کنه، خطا رو پیدا کنه و دوباره اصلاح کنه – اونجاست که تفاوت مدلهای قویتر خودش رو نشون میده.
کاربردهای Claude Opus 5.5 طبق مواد منتشرشده Anthropic این حوزهها رو پوشش میده:
کدنویسی عاملمحور و مهاجرت کدبیسهای بزرگ
استفاده از کامپیوتر برای انجام وظایف چندمرحلهای
تحلیل اسناد طولانی و مدلسازی مالی
پژوهش علمی و چندرشتهای
کار دانشی که نیاز به حفظ زمینه در طول یک گفتگوی طولانی داره
نکته مهمی که باید در نظر بگیری اینه که استفاده از یک مدل قدرتمند برای کارهای ساده و روزمره فقط هزینه اضافه میکنه، بدون اینکه فایده محسوسی داشته باشه. اگه کارت محدود به تولید متن کوتاه یا پاسخهای سادهست، این مدل شاید بیش از نیازت باشه.
این مدل چه جایگاهی در خانواده مدلهای Claude داره؟
خانواده Claude معمولاً سه رده داره: مدلهای سریع و سبک برای کارهای روزمره، مدلهای میانی برای تعادل بین سرعت و کیفیت، و مدلهای رده Opus برای سنگینترین وظایف. Opus 5.5 در بالاترین رده این خانواده قرار میگیره.
طبق صفحه رسمی Anthropic، Opus 5.5 در بیشتر کارها در سطح Claude Fable 5.1 عمل میکنه، اما هزینه اجراش ۴۰ درصد کمتر از Opus 5 هست. این یعنی جایگاه Opus 5.5 نه صرفاً «قویترین مدل ممکن»، بلکه «قویترین مدلی که هزینهی اجراش هم منطقیتر شده».
تفاوت اصلی این رده با مدلهای سریعتر و ارزونتر در جاهایی دیده میشه که:
زنجیره تصمیمها طولانیه و مدل باید چند قدم بعدی رو هم در نظر بگیره
استفاده مکرر از ابزارها (tool use) لازمه
زمینه گفتگو یا سند ورودی خیلی بزرگه و باید حفظ بشه
با این حال، به این نکته دقت کن که نام یا امتیاز بنچمارک بهتنهایی معیار کافی برای انتخاب نیست. Anthropic خودش هم اشاره کرده که در استفاده واقعی، فاصله بین Opus 5.5 و مدلهای همردهاش کمتر از چیزیه که فقط از روی امتیازهای بنچمارک به نظر میرسه. بهترین راه، ارزیابی مدل روی داده و وظیفه واقعی خودته، نه اتکا به رتبهبندی عمومی.
مشخصات و قابلیتهای Claude Opus 5.5
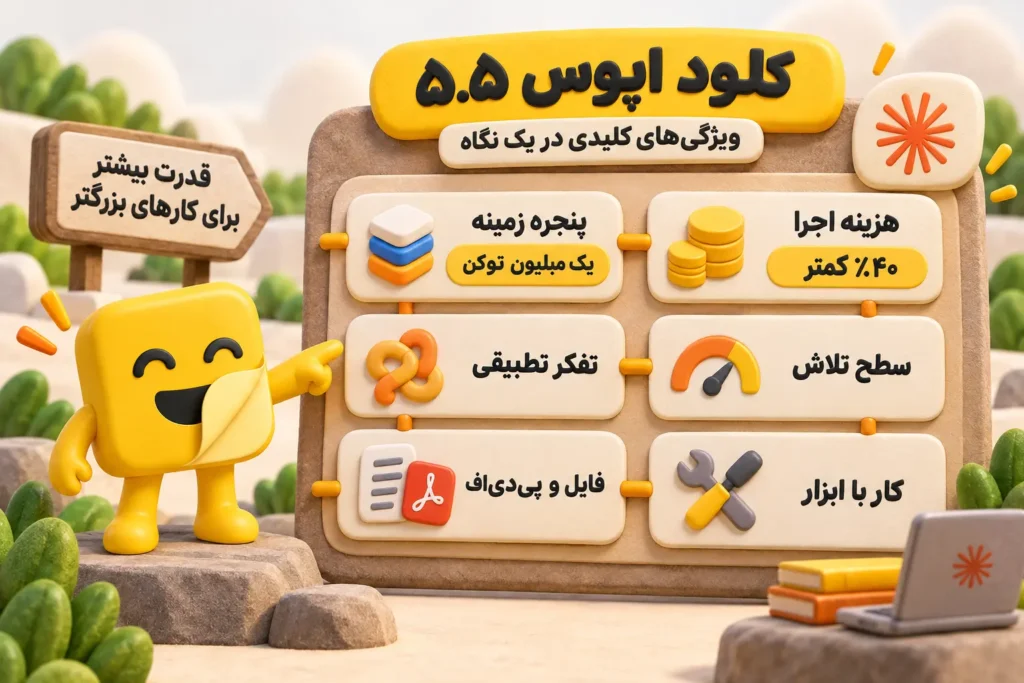
Claude Opus 5.5 با شناسه مدل مشخص عرضه شده و مثل نسخههای اخیر خانواده Claude، پنجره زمینه یک میلیون توکنی داره. این یعنی میتونه حجم زیادی از متن، کد یا اسناد رو در یک گفتگو نگه داره و بهشون ارجاع بده.
جدول زیر خلاصهای از مشخصات کلیدی این مدل رو نشون میده:
ویژگی
توضیح
جایگاه در خانواده
اولین مدل خانواده Claude 5.5، رده Opus
پنجره زمینه
یک میلیون توکن
کاهش هزینه نسبت به Opus 5
حدود ۴۰ درصد
نوع تفکر
Adaptive thinking (همیشه فعال)
سطوح Effort
low، medium، high، xhigh، max
قابلیتهای جانبی
Prompt caching، Files API، پردازش PDF، Vision، Computer use
یکی از تغییرهای مهم نسبت به نسلهای قبلی، مفهوم adaptive thinking هست که همیشه فعاله و با سطح effort کنترل میشه. این یعنی بهجای روشن یا خاموشکردن حالت تفکر، تو میزان عمق پردازش مدل رو با انتخاب سطح effort – از low تا max – تنظیم میکنی.برای اطلاعات بیشتر در این مورد میتونی راهنمای پرامپت نویسی Claude؛ 5 قانون طلایی برای Opus 5 رو بخونی.
مدل همچنین از قابلیتهایی مثل تغییر ابزار در میانه گفتگو (بدون نیاز به شروع مکالمه جدید) و فشردهسازی زمینه (compaction) پشتیبانی میکنه که برای وظایف طولانی و چندمرحلهای مفیدن.
با این حال، پنجره زمینه بزرگ بهتنهایی تضمینی برای کیفیت خروجی نیست. داشتن یک میلیون توکن ظرفیت یعنی مدل میتونه اطلاعات بیشتری رو ببینه، اما اینکه چطور از این اطلاعات استفاده کنه و چه تصمیمی بگیره، به کیفیت پرامپت و طراحی وظیفه هم بستگی داره.
پیشنهاد ویژه کادینر
خرید اشتراک قانونی و اختصاصی برای استفاده پایدارتر
اشتراکهای اختصاصی کادینر روی ایمیل شخصی خود کاربر، همراه با گارانتی و پشتیبانی کامل ارائه میشوند.
Claude Opus 5.5 در کارهای عاملمحور و دانشی چه عملکردی داره؟
عامل هوش مصنوعی (AI agent) با یک چتبات ساده فرق داره: چتبات فقط جواب میده، اما عامل میتونه چند مرحله رو پشت سر هم اجرا کنه، از ابزار استفاده کنه، نتیجه رو بررسی کنه و بر اساس اون تصمیم بعدی رو بگیره.برای اطلاعات بیشتر در این مورد میتونی راهنمای Claude Sonnet 5: راهنمای کامل قابلیتهای agentic و مقایسه با Opus رو بخونی.
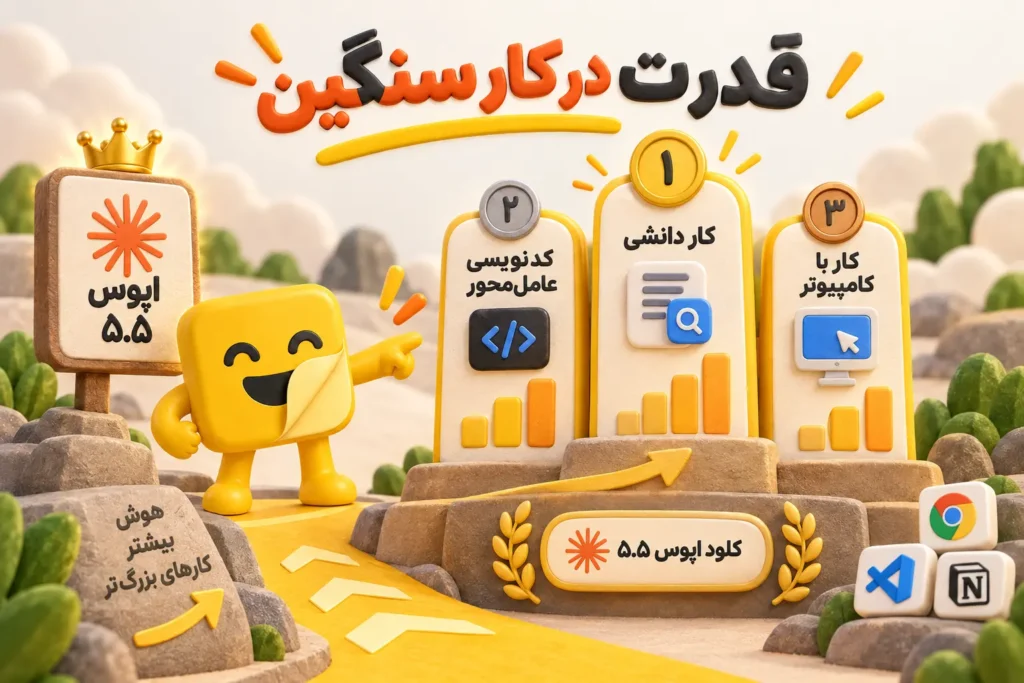
طبق دادههای منتشرشده Anthropic، Claude Opus 5.5 در چند بنچمارک مرتبط با کدنویسی عاملمحور و کار دانشی نتایج قابلتوجهی ثبت کرده:
بنچمارک
حوزه
امتیاز Opus 5.5
Terminal-Bench 4.0
کدنویسی عاملمحور
۶۶.۴٪
FrontierCode v1.1
کدنویسی عاملمحور
۵۴.۴٪
CursorBench 4.0
کدنویسی عاملمحور
۵۷.۸٪
GDPval-AA v2.1
کار دانشی
۱۸۴۶
AutomationBench
فرایندهای کسبوکاری
۴۰.۰٪
Humanity’s Last Exam
استدلال چندرشتهای
۶۷.۷٪ (با ابزار)
OSWorld 2.0
استفاده از کامپیوتر
۸۱.۸٪ (بخشی)
این امتیازها طبق اعلام Anthropic با استفاده از adaptive thinking در سطح effort حداکثری به دست اومدن. یعنی نتایج بالا، بهترین حالت ممکن مدل رو نشون میدن، نه لزوماً چیزی که در تنظیمات پیشفرض یا effort پایینتر تجربه میکنی.
نمودارها و جدولهای کامل خود Anthropic رو هم میتونی اینجا ببینی:
Terminal-Bench 4.0Accuracy vs Cost
Opus 5.5
Fable 5.1
Opus 5
GPT-6 Astra
GPT-5.6 Sol
Terminal-Bench 4.0 measures how well a model can complete complex, multi-step professional tasks within a command line interface. Opus 5.5 at default effort beats Opus 5 at max effort for about a fifth of the cost. It matches GPT-6 Astra at about 40% of the cost.
FrontierCode v1.1, main setAccuracy vs Cost
Opus 5.5
Fable 5.1
Opus 5
GPT-6 Astra
GPT-5.6 Sol
FrontierCode measures whether an agent’s code changes would be merged. At default effort (medium), Opus 5.5 scores 54.6%, higher than all other models, beating GPT-6 Astra’s top score (53.3%) for about a fifth of the cost per task.
CursorBench 4.0Accuracy vs Cost
Opus 5.5
Fable 5.1
Opus 5
GPT-5.6 Sol
CursorBench evaluates coding agents on ambiguous, multi-file tasks taken from real Cursor sessions. At default effort (medium), Opus 5.5 scores 52.5%, compared to 51.8% for Fable 5.1 (max) and 46.6% for Opus 5 (max). It beats GPT-5.6 Sol’s top score (41.7%) by 11 points for about a third of the cost per task.
GDPval-AA v2.1Elo vs Cost
Opus 5.5
Fable 5.1
Opus 5
GPT-6 Astra
GPT-5.6 Sol
Artificial Analysis’s GDPval-AA v2.1 evaluates agents on real-world professional work across 44 occupations. At max effort, Opus 5.5 scores 1846 Elo, where Fable 5.1 scores 1735 and Opus 5 scores 1708. At default effort (medium), Opus 5.5 beats GPT-6 Astra at max effort for about a fifth of the cost per task.
AutomationBenchAccuracy vs Cost
Opus 5.5
Opus 5
GPT-6 Astra
GPT-5.6 Sol
AutomationBench, built by Zapier, tests whether an agent can carry out real business workflows across many connected apps. Opus 5.5 outscores Opus 5 and GPT-5.6 Sol at every effort level.
WANDRAccuracy vs Cost
Opus 5.5
Fable 5.1
Opus 5
Perplexity’s WANDR benchmark measures agents on large data collection tasks. Opus 5.5 outperforms Fable 5.1 and Opus 5 at a lower cost per task4.
4WANDR: Claude models were run with offline versions of the web search and web fetch tools, programmatic tool calling, code execution, and a 980k-token task budget. This differs from Perplexity’s published setup, scores are not directly comparable across the two and we only show models scored under the same conditions.
نکته کلیدی اینه که این بنچمارکها روی مجموعه دادههای استاندارد اجرا شدن، نه روی کدبیس یا دادههای اختصاصی سازمان تو. عملکرد یک مدل روی Terminal-Bench یا FrontierCode نشون میده اون مدل در شرایط کنترلشده چطور کار میکنه، اما تضمین نمیکنه همون نتیجه رو روی ابزارها، داده و فرایندهای خاص تیم تو هم تکرار کنه. برای همین، ارزیابی داخلی روی نمونه واقعی از کار خودت، قدم ضروری قبل از تصمیم نهاییه.
امنیت و محدودیتهای Claude Opus 5.5 رو چطور باید دید؟
Anthropic اعلام کرده که Opus 5.5 بهترین امتیاز رو در ممیزی رفتاری خودکار این شرکت، یعنی مجموعه آزمونهای همسویی که Claude رو در هزاران سناریوی شبیهسازیشده تست میکنه، به دست آورده. همچنین چون این مدل در حوزههای زیستشناسی و امنیت سایبری با Claude Mythos 5.1 قابلمقایسهست، با تدابیر امنیتی مشابه همون مدل عرضه شده.
با این حال، این امتیازهای بالا به معنی امنیت مطلق نیست. هیچ مدل زبانی بهتنهایی نمیتونه سد کامل در برابر سوءاستفاده یا خطای اجرایی باشه، حتی اگه مقاومتش در برابر تلاشهای نفوذ (prompt injection) بهبود یافته باشه.
برای همین، وقتی از Opus 5.5 در نقش یک عامل با دسترسی به ابزارها یا کامپیوتر استفاده میکنی، بهتره یک دفاع چندلایه در نظر بگیری:
محدودکردن دسترسی مدل به کمترین سطح لازم برای انجام وظیفه
اجرای وظایف حساس در محیط ایزوله (sandbox)
تعیین نقطههای تأیید انسانی قبل از اقدامهای برگشتناپذیر
ثبت کامل اقدامهای مدل برای بررسی بعدی
اعتبارسنجی ورودیهایی که از طریق ابزارها به مدل میرسن
همچنین باید رفتار refusal (امتناع از پاسخ) و stop_reason مدل رو در طراحی سیستم لحاظ کنی؛ یعنی وقتی مدل تصمیم میگیره کاری رو انجام نده یا متوقف بشه، سیستم تو باید یک مسیر جایگزین (fallback) داشته باشه، نه اینکه فقط منتظر پاسخ بمونه.
برای کاربردهای پرریسک – مثل گزارشهای مالی، تصمیمهای حقوقی یا پزشکی – بازبینی انسانی همچنان بخش ضروری فرایند باقی میمونه، صرفنظر از اینکه مدل چقدر در بنچمارکهای امنیتی امتیاز خوبی گرفته.
مهاجرت به Claude Opus 5.5 چه تغییرهایی لازم داره؟
اگه از Opus 5 استفاده میکنی و میخوای به Opus 5.5 منتقل بشی، چند تغییر فنی هست که باید قبل از انتقال ترافیک تولید بررسی کنی. این تغییرها بیشتر مربوط به نحوه مدیریت thinking، ابزارها و بلوکهای پاسخ هستن.
مراحل کلی برای مهاجرت اینطوریه:
1بررسی تنظیمات thinking: در Opus 5.5، حالت تفکر (thinking) دیگه به شکل قبلی غیرفعال نمیشه؛ بهجاش باید از سطحهای effort استفاده کنی. اگه کد قبلیت بر اساس روشن/خاموشکردن thinking نوشته شده، باید این منطق رو بازنویسی کنی.
2جایگزینی forced tool use: اگه در پیادهسازی قبلی از اجبار به استفاده از یک ابزار مشخص (forced tool use) استفاده میکردی، باید بررسی کنی این قابلیت در نسخه جدید چطور پشتیبانی میشه و مسیرهای جایگزین مثل حالت auto، strict tool use یا خروجیهای ساختیافته (structured outputs) رو امتحان کنی.
3بازبینی thinking blocks: بلوکهای تفکر مدل به مدل و به گفتگوی مشخص وابستهن. یعنی نمیشه یک thinking block رو از یک مدل یا گفتگو گرفت و مستقیم در گفتگوی دیگه استفاده کرد.
4بررسی ابزار computer use: اگه از قابلیت computer use در Claude API یا زیرساختهای ابری استفاده میکنی، رفتار این ابزار ممکنه بین پلتفرمها تفاوت داشته باشه؛ قبل از انتقال کامل، این بخش رو جداگانه تست کن.
5پردازش بلوکها بر اساس نوع: متنهای بهروزرسانی پیشرفت (progress update) و انواع دیگر بلوکهای پاسخ ممکنه ساختار متفاوتی داشته باشن؛ کد پردازش پاسخ باید بر اساس نوع (type) هر بلوک عمل کنه، نه فرض ثابت روی ساختار قبلی.
6اجرای تست روی وظایف واقعی: پیش از انتقال کامل ترافیک تولید، وظایف نمونه از کار واقعی سازمانت رو روی مدل جدید اجرا کن و نتیجه رو با رفتار قبلی مقایسه کن.
مهاجرت از Opus 5 صرفاً تعویض نام مدل در کد نیست؛ نادیدهگرفتن هرکدوم از این تغییرها میتونه باعث بشه پاسخهای مدل در محیط عملیاتی رفتار غیرمنتظرهای داشته باشن.
آیا دسترسی به Claude Opus 5.5 برای شما ارزش داره؟
این سؤال بستگی به نوع کارت داره. اگه برنامهنویسی میکنی و پروژههات شامل مهاجرت کدبیس، رفع باگهای پیچیده یا کار عاملمحور روی چند فایل هست، Opus 5.5 میتونه گزینه منطقیتری نسبت به مدلهای سبکتر باشه و دسترسی به Claude Pro هم برات مهم باشه. همینطور برای تیمهای محصول که نیاز به تحلیل اسناد طولانی دارن، تیمهای امنیتی که روی سناریوهای پیچیده کار میکنن، یا پژوهشگرانی که به استدلال چندرشتهای نیاز دارن.
اما اگه کارت بیشتر شامل نوشتن متن کوتاه، پاسخ به سؤالات ساده یا تولید محتوای روزمرهست، احتمالاً یک مدل سریعتر و ارزونتر همون نتیجه رو با هزینه کمتر بهت میده. خیلی از تیمها بهجای انتخاب یک مدل برای همه کارها، از ترکیب مدلها استفاده میکنن: مدل سبک برای وظایف روزمره و Opus 5.5 برای وظایف پیچیده و پرریسک.برای مقایسهٔ بهتر میتونی مقایسه Claude Sonnet 5 با Opus 4.8: کدام برای کدنویسی بهتر است؟ رو ببینی.
اگه هدفت استفاده مستقیم از سرویس Claude برای نوشتن، تحلیل اسناد یا کدنویسیه، کادینر اکانت Claude Pro رو بهصورت اختصاصی و روی ایمیل شخصی خودت فعال میکنه؛ یعنی تاریخچه گفتگوها و تنظیماتت حفظ میمونه و نیازی نیست نگران تغییر رمز عبور توسط فروشنده باشی. این مسیر برای دسترسی به جدیدترین مدل عمومی خانواده Claude مناسبه، اما اگه قراره مدل رو داخل یک ابزار یا workflow سفارشی خودت ادغام کنی، اون بخش نیاز به دسترسی API و زیرساخت توسعهدهنده جداگانه داره که خارج از دسترسی حساب Pro قرار میگیره. قیمت بهروز رو میتونی در صفحه محصول Claude کادینر ببینی و برای هر سؤالی هم پشتیبانی کادینر از طریق تلگرام در دسترسته.
پیشنهاد ویژه کادینر
خرید اشتراک قانونی و اختصاصی برای استفاده پایدارتر
اشتراکهای اختصاصی کادینر روی ایمیل شخصی خود کاربر، همراه با گارانتی و پشتیبانی کامل ارائه میشوند.
Claude Opus 5.5 برای کارهای پیچیده، چندمرحلهای و عاملمحور طراحی شده – از کدنویسی و مهاجرت کدبیس گرفته تا تحلیل اسناد طولانی و پژوهش چندرشتهای. اما ارزش واقعی این مدل فقط با در نظر گرفتن همزمان کیفیت، هزینه، سرعت و نیاز واقعی پروژه مشخص میشه، نه صرفاً با تکیه بر امتیاز بنچمارک یا نام پرچمدار مدل. اگه کارت شامل وظایف ساده و روزمرهست، مدلهای سبکتر معمولاً کفایت میکنن؛ اما برای پروژههای پیچیدهای که نیاز به حفظ زمینه طولانی و تصمیمگیری چندمرحلهای دارن، Opus 5.5 گزینهای هست که ارزش بررسی داره. پیش از هر انتخاب نهایی، وضعیت فعلی قیمت، دسترسی و محدودیتهای مدل رو در منابع رسمی چک کن.
سؤالات متداول
Claude Opus 5.5 برای چه نوع کارهایی ارزش بیشتری داره؟
Claude Opus 5.5 بیشتر برای کارهای چندمرحلهای مثل کدنویسی، مهاجرت نرمافزار، تحلیل داده، بررسی اسناد طولانی، ساخت مدل مالی و پژوهش ارزش داره. اگر کار فقط پاسخگویی روزمره یا تولید متن کوتاهه، مدل سریعتر و ارزانتر احتمالاً نیازت رو بهتر پوشش میده.
آیا قیمت API Claude Opus 5.5 برای عاملهای هوش مصنوعی بالاست؟
هزینه واقعی API فقط به قیمت هر توکن محدود نمیشه و تعداد فراخوانی ابزار، طول زمینه، زمان اجرا و تکرار خطا هم روی اون اثر میذاره. برای پایین آوردن هزینه، باید تعداد گامهای عامل، کشکردن زمینه و مسیرهای خطا رو روی وظایف واقعی آزمایش کنی.
برای مهاجرت از Opus 5 به Claude Opus 5.5 چه چیزهایی باید تست بشه؟
در مهاجرت از Opus 5 باید تنظیمات thinking و effort، ساختار بلوکهای پاسخ، نحوه استفاده از ابزارها و رفتار computer use رو دوباره بررسی کنی. اجرای آزمایشی روی وظایف واقعی، ثبت خطاها و تأیید خروجی پیش از انتقال ترافیک تولید، ریسک مهاجرت رو کمتر میکنه.
دسترسی به Claude Pro برای استفاده از Claude Opus 5.5 کافیه؟
Claude Pro برای استفاده مستقیم از سرویس Claude طراحی شده، اما توسعهدهندههایی که میخوان مدل رو داخل نرمافزار یا عامل اختصاصی به کار بگیرن، معمولاً به API و تنظیمات فنی جداگانه نیاز دارن. قبل از تصمیم، دسترسی فعلی، سقف مصرف و پشتیبانی مدل رو بررسی کن.
منابع و مراجع
برای بررسی و بهروزرسانی اطلاعات این مقاله از منابع زیر استفاده شده است:


هنوز دیدگاهی برای این محصول ثبت نشده است.